ブログ
最新情報をお届けします。
パターン認識:AIはいかにして人間が読めないものを読み解くのか
著者:Swetha Kannan
原文:https://www.knime.com/blog/pattern-recognition-how-ai-reads-what-people-cant
社内に眠る「埋もれたライブラリ」を実用的なインテリジェンスに変換する
目次
誰にも開けなかった書物を読み解く
西暦79年、ヴェスヴィオ火山の噴火によって、ヘルクラネウムの書庫(ライブラリ)が地中に埋もれました。古代の巻物は焼失を免れたものの、炭化した灰の塊となってしまいました。触れるだけで崩れてしまうため、約2,000年もの間、誰も読むことができない状態が続いていました。
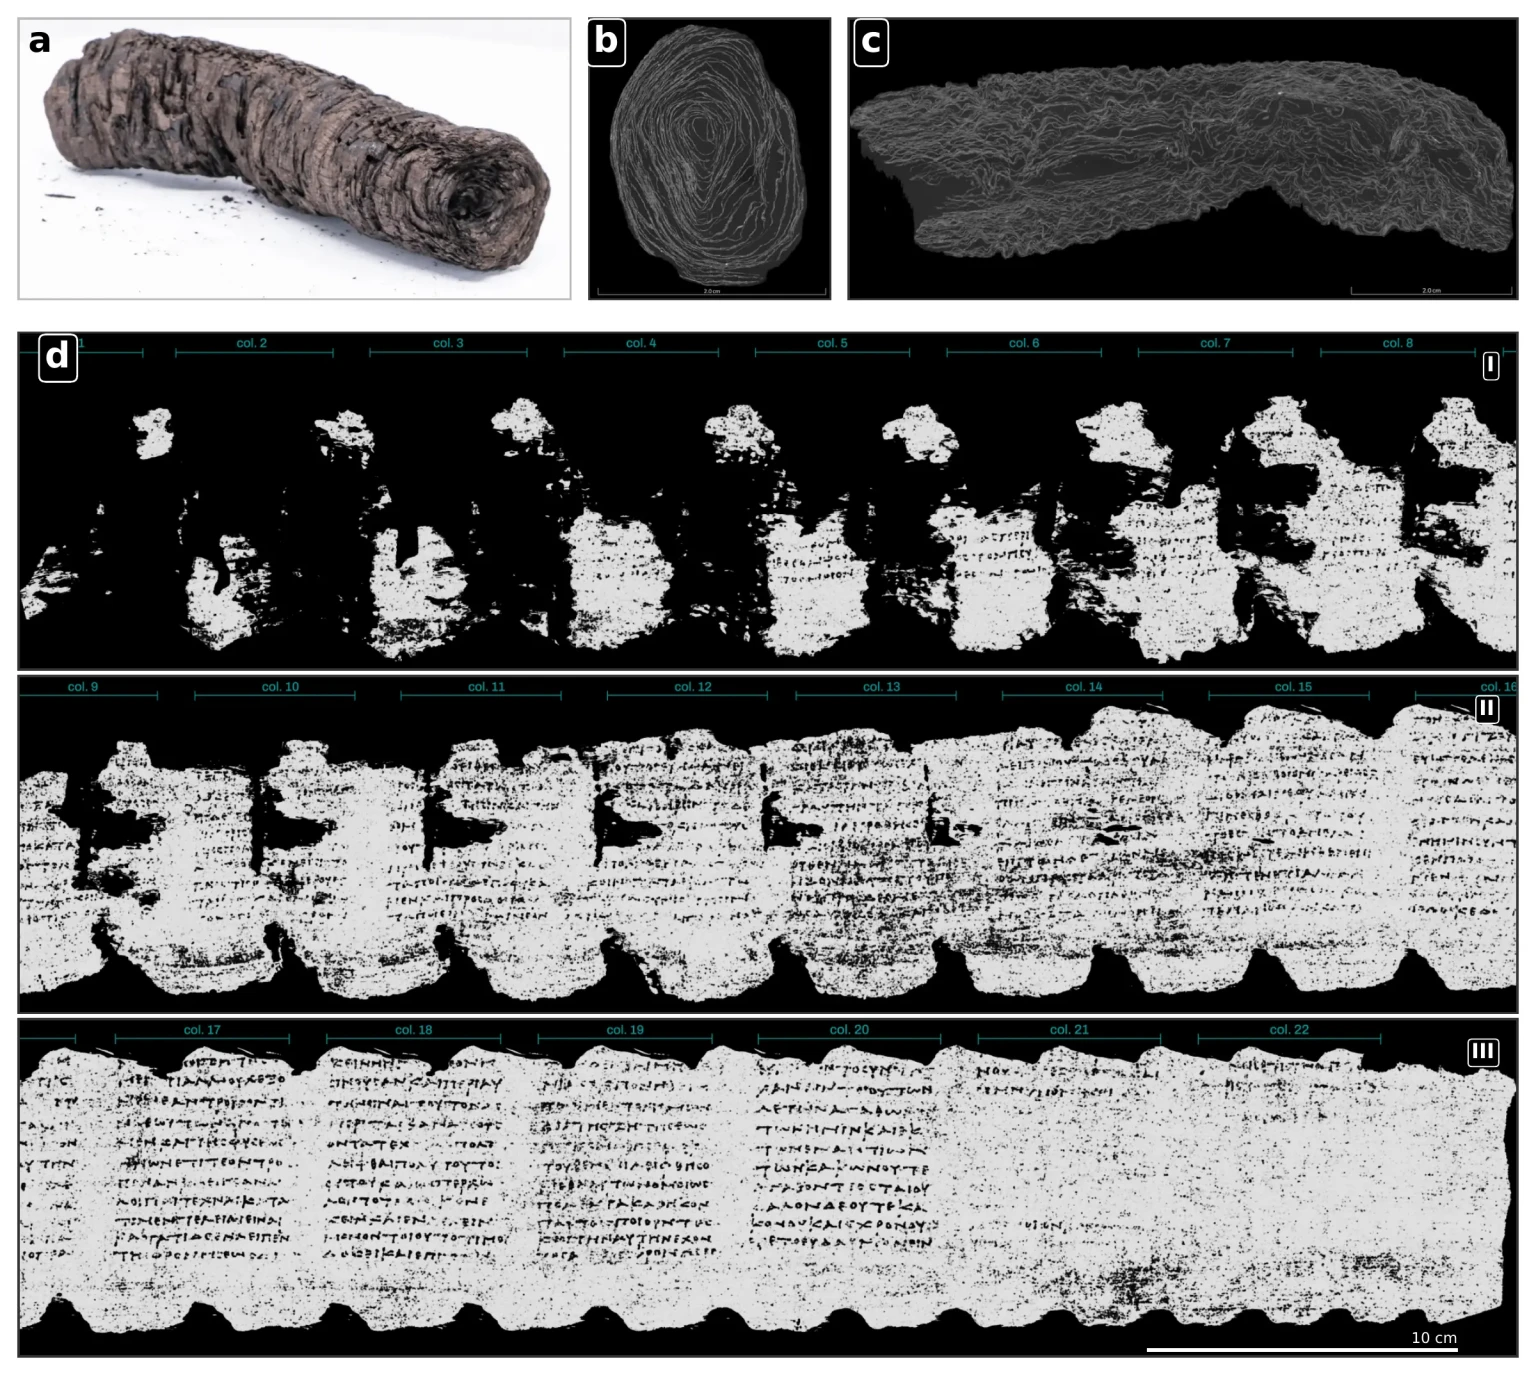
しかし研究者たちは、巻物を開くことなく解読する方法を発見しました。高解像度X線で巻物をスキャンし、内部に残るわずかなインクの痕跡——人間の目には微細すぎるパターン——を検出するようにモデルを学習させたのです。モデルは「インクがどのように見えるか」を学習したため、人間の目には見えないものを発見できるようになりました。そして先月、研究チームは史上初めて、1つの巻物全体を最初から最後まで完全に読み解くことに成功しました。
あなたのビジネスにも、同じように「埋もれたライブラリ」が存在しています。企業が保有するデータの約80%は、スキャンされた契約書、請求書、保険金請求書、各種フォームなどの非構造化データです。これらはどのシステムも読み取ることができず、誰も確認する時間がありません。その大部分は使われないまま放置されています。パターン認識こそが、このデータをようやく開くための手段です。モデルに十分な例を示せば、あなたに代わって解読を行ってくれます。
例から学習する様子を見る
Googleの「Quick, Draw!」は、20秒間でネコやハリネズミの絵を描く間に、ニューラルネットワークがそれが何かを推測するツールです。モデルは驚くほどの高確率で正解を当てます。なぜなら、あなたが描く前に、すでに10億を超える落書きから学習しているからです。
モデルに十分な例を示せば、次に示されたものを認識できるようになります。古代の巻物を解読したのと同じ仕組みが、今や私たちの手元で利用できるのです。
おすすめの1冊:機械学習について書かれた最も面白い本
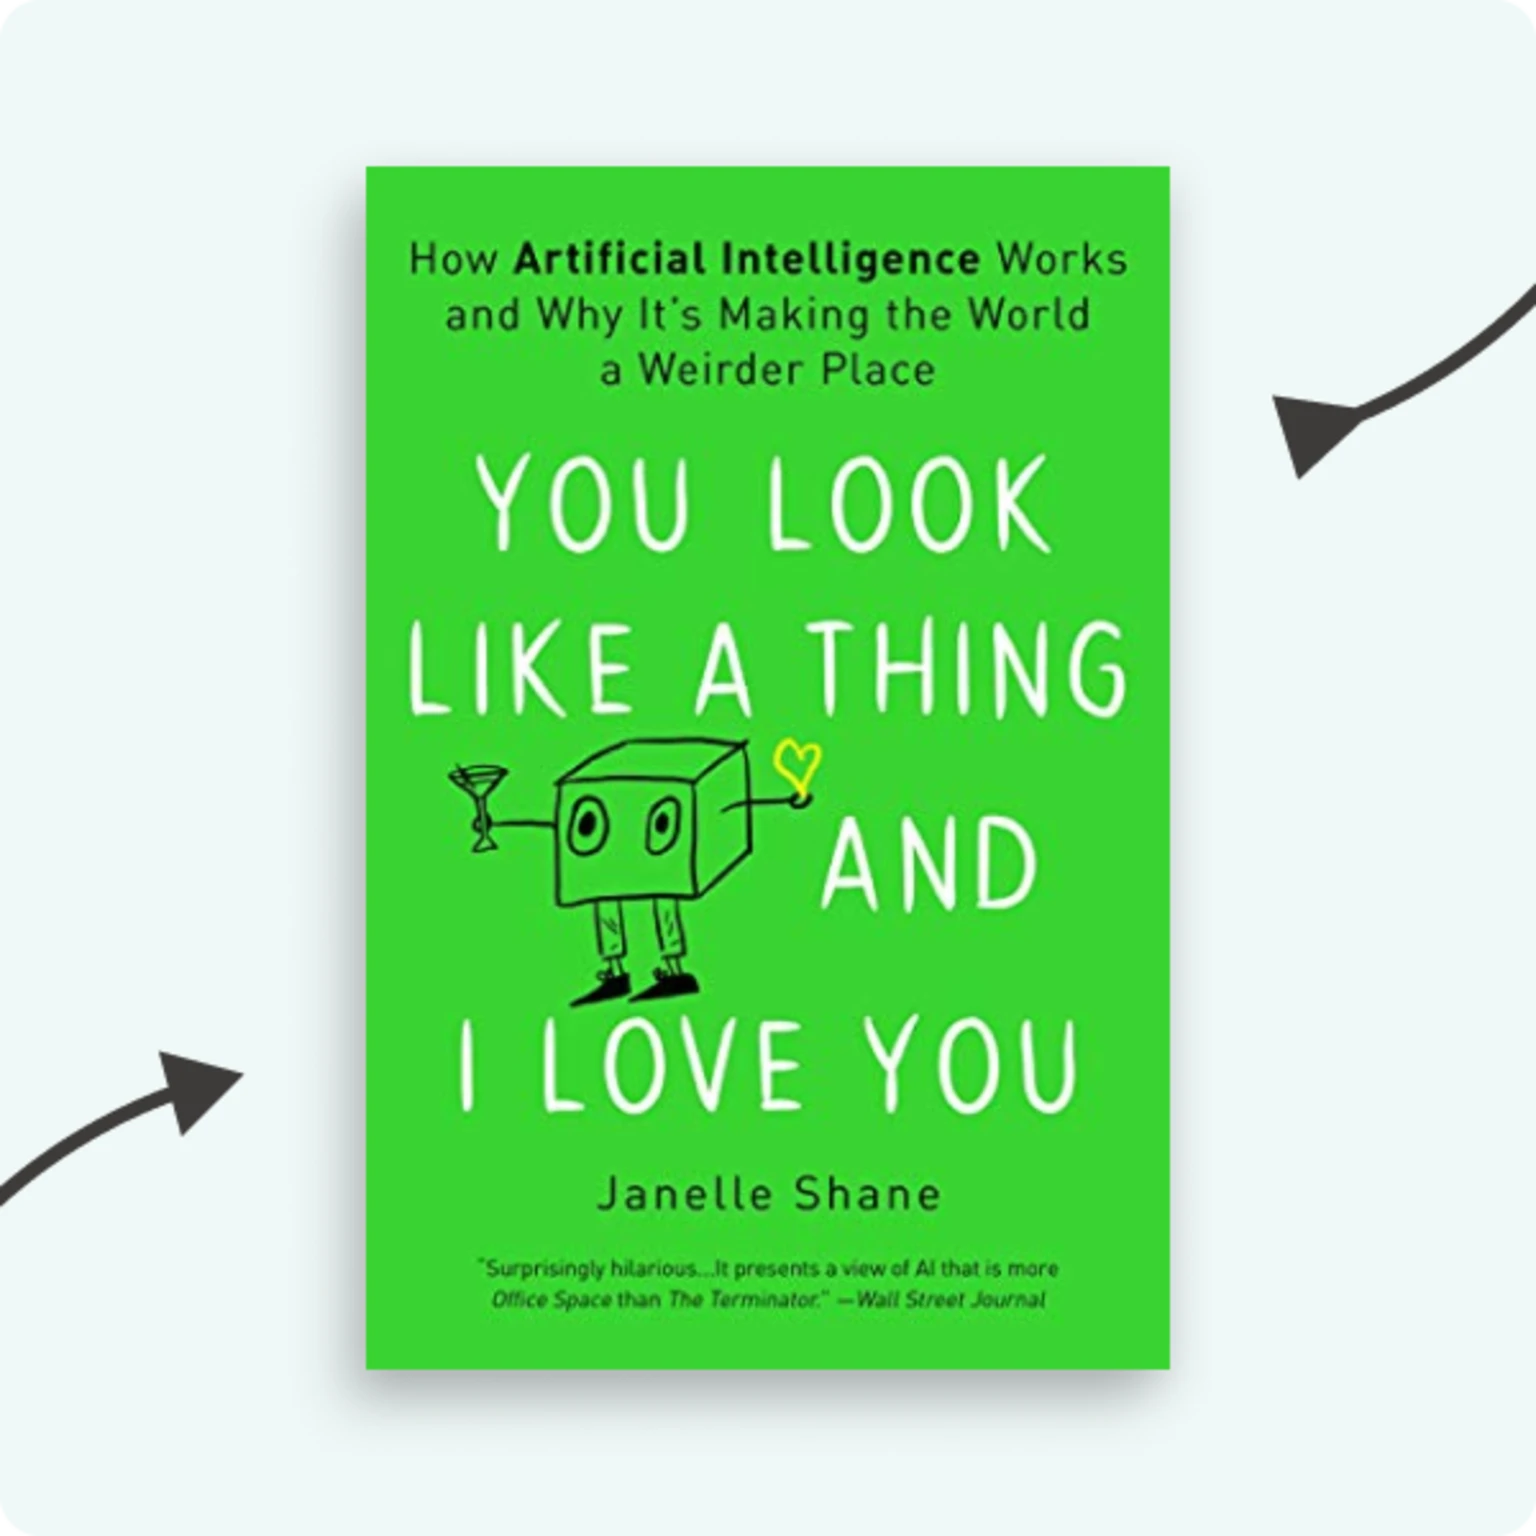
ジャネル・シェーン著の『You Look Like a Thing and I Love You』は、塗料の色名の命名、レシピの考案、ナンパの口説き文句の作成など、AIモデルに変わったタスクを与え、整っていない雑多な例から学習させたときに何が起きるかを示しています。
この本は、1つの事実を明確に示しています。それは、「モデルの性能は、与えられた例の質と量次第である」ということです。古代の巻物を読み解くことであれ、手描きの落書きを当てることであれ、得られる教訓はまったく同じです。